超大规模波形图,如何实现缩放不卡顿
概要
高采样率长时序波形数据量巨大,若每次缩放、拖动都读取全量原始点并实时降采样,计算与IO负载极高,界面易出现长时间卡顿。本方案采用预烘焙(即提前对原始波形完成多分辨率降采样计算并持久化存储,渲染时直接复用结果,以空间换取交互流畅度)的分层思路,兼顾大范围浏览流畅度与无级放大、局部框选能力。
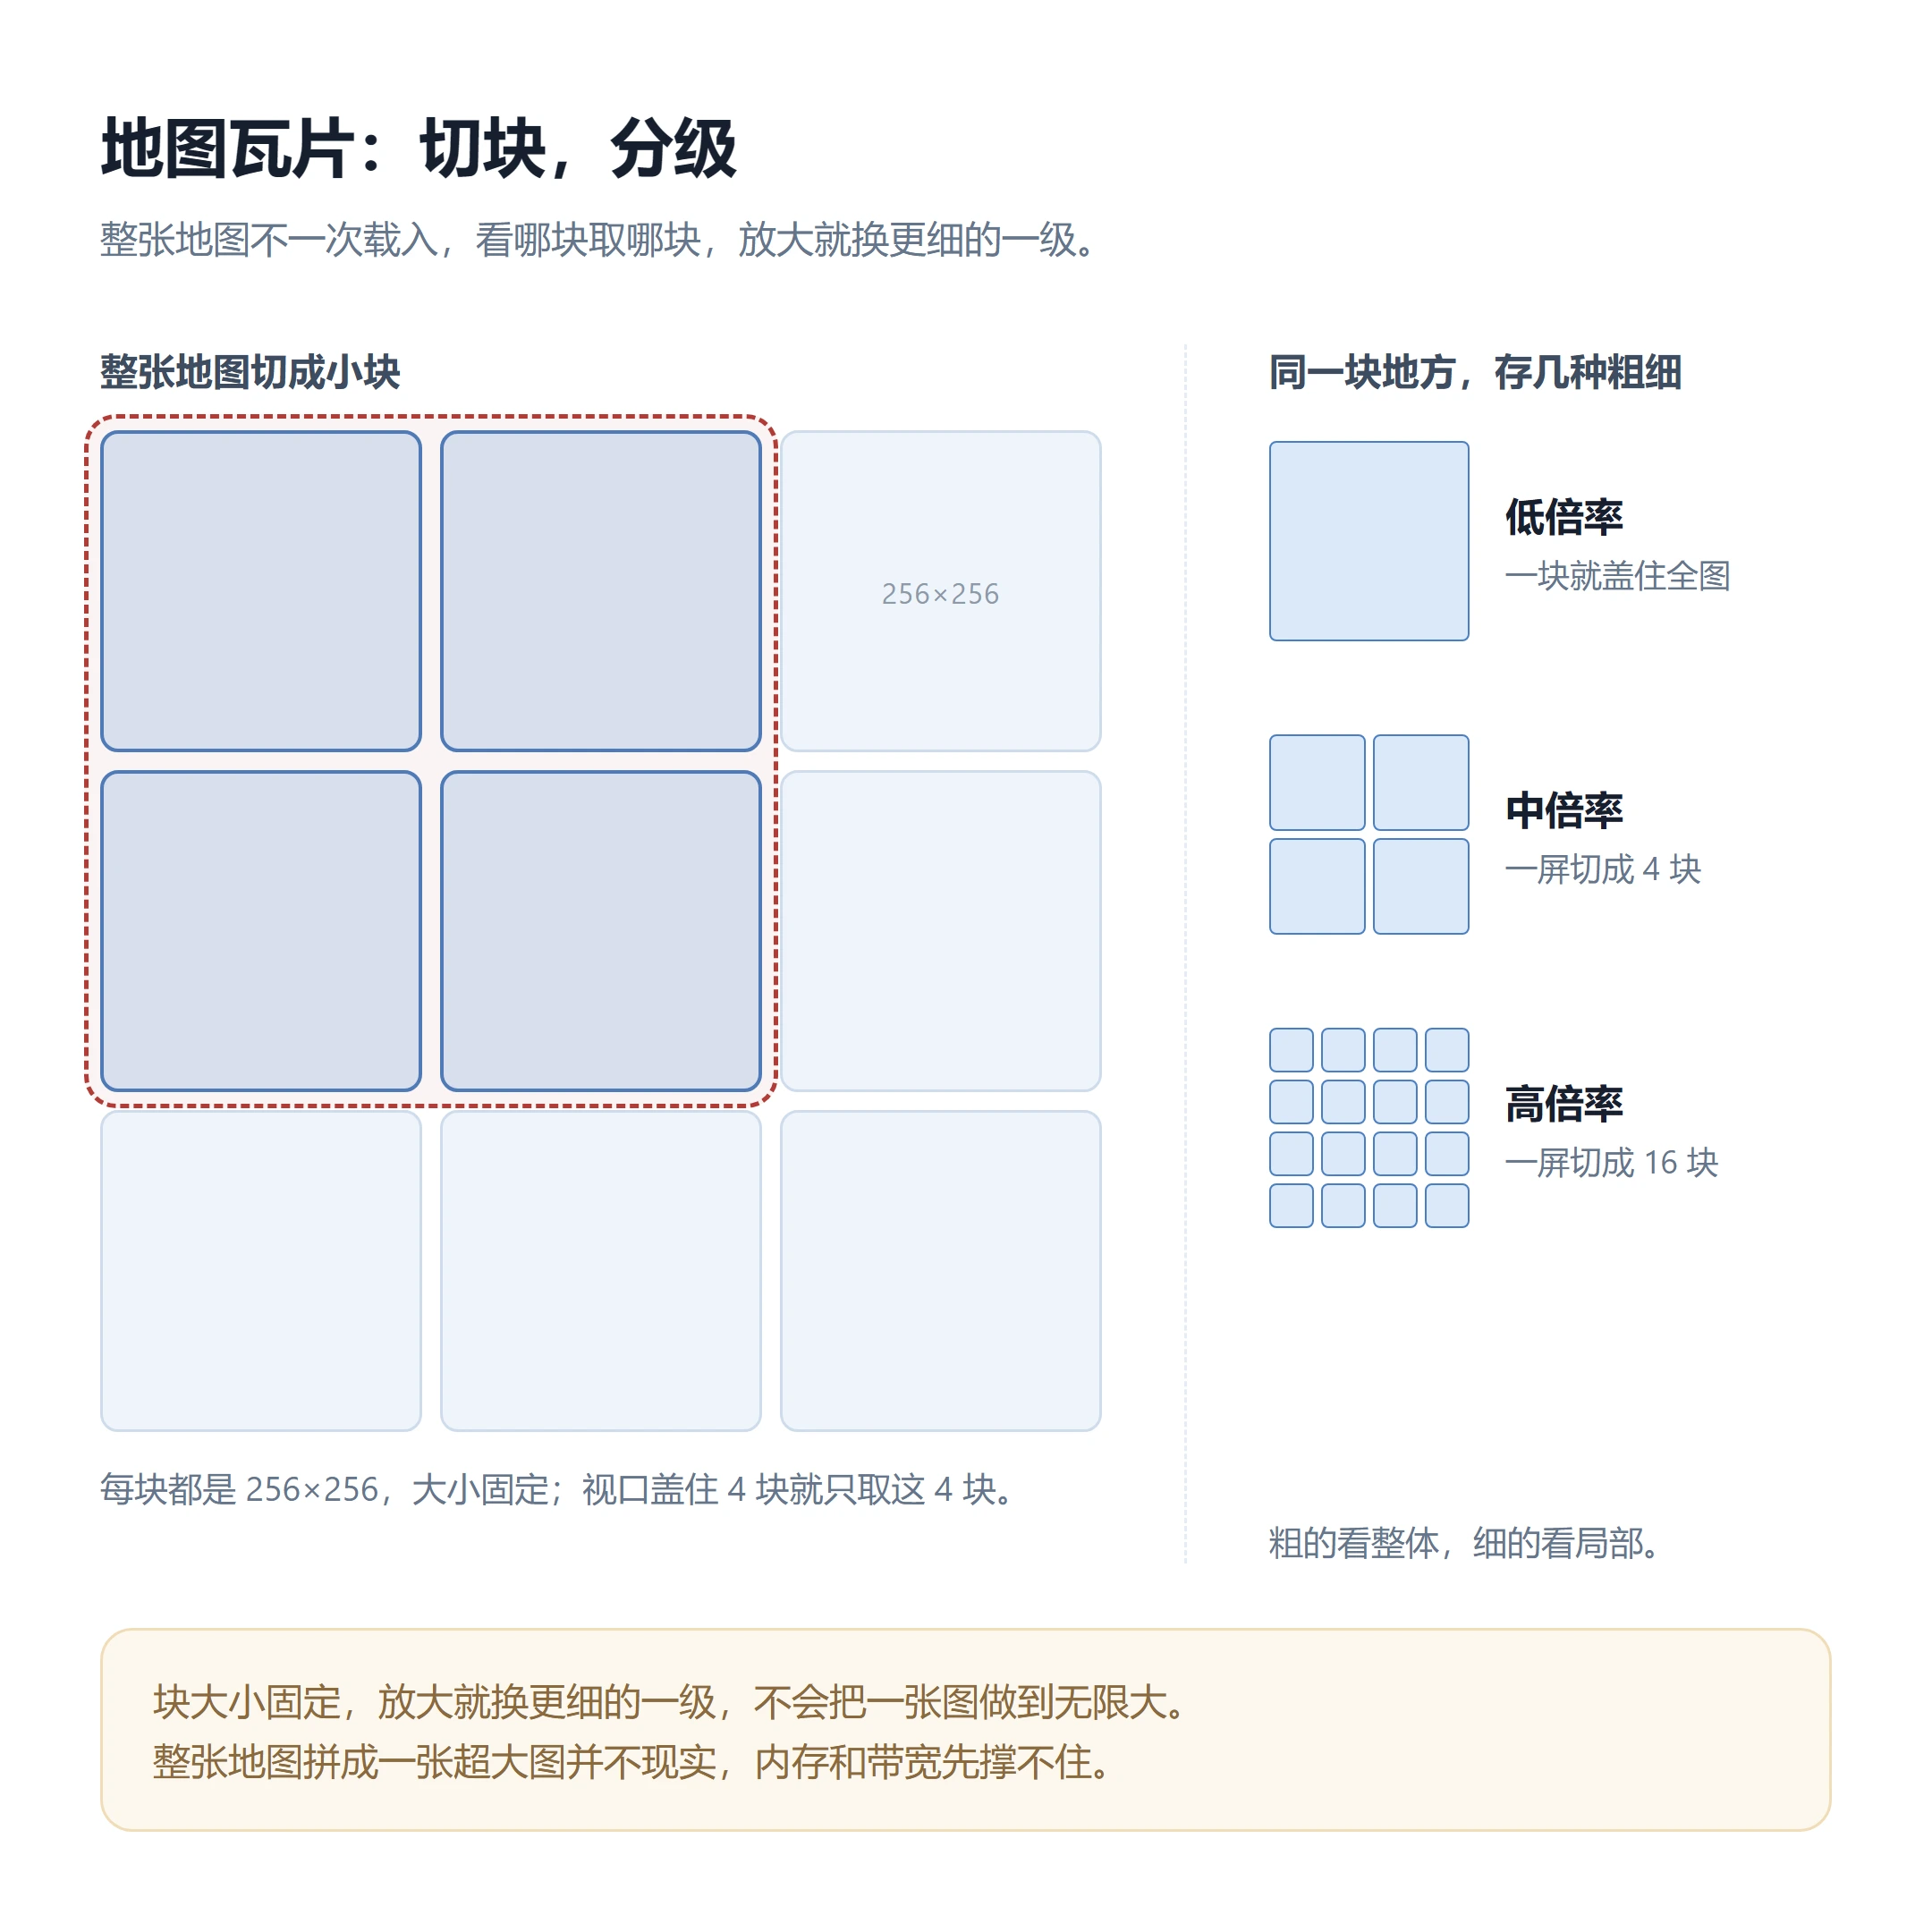
借鉴地图瓦片的分层思想,我们将计算与存储加载拆分为两个独立概念,二者职责边界明确:
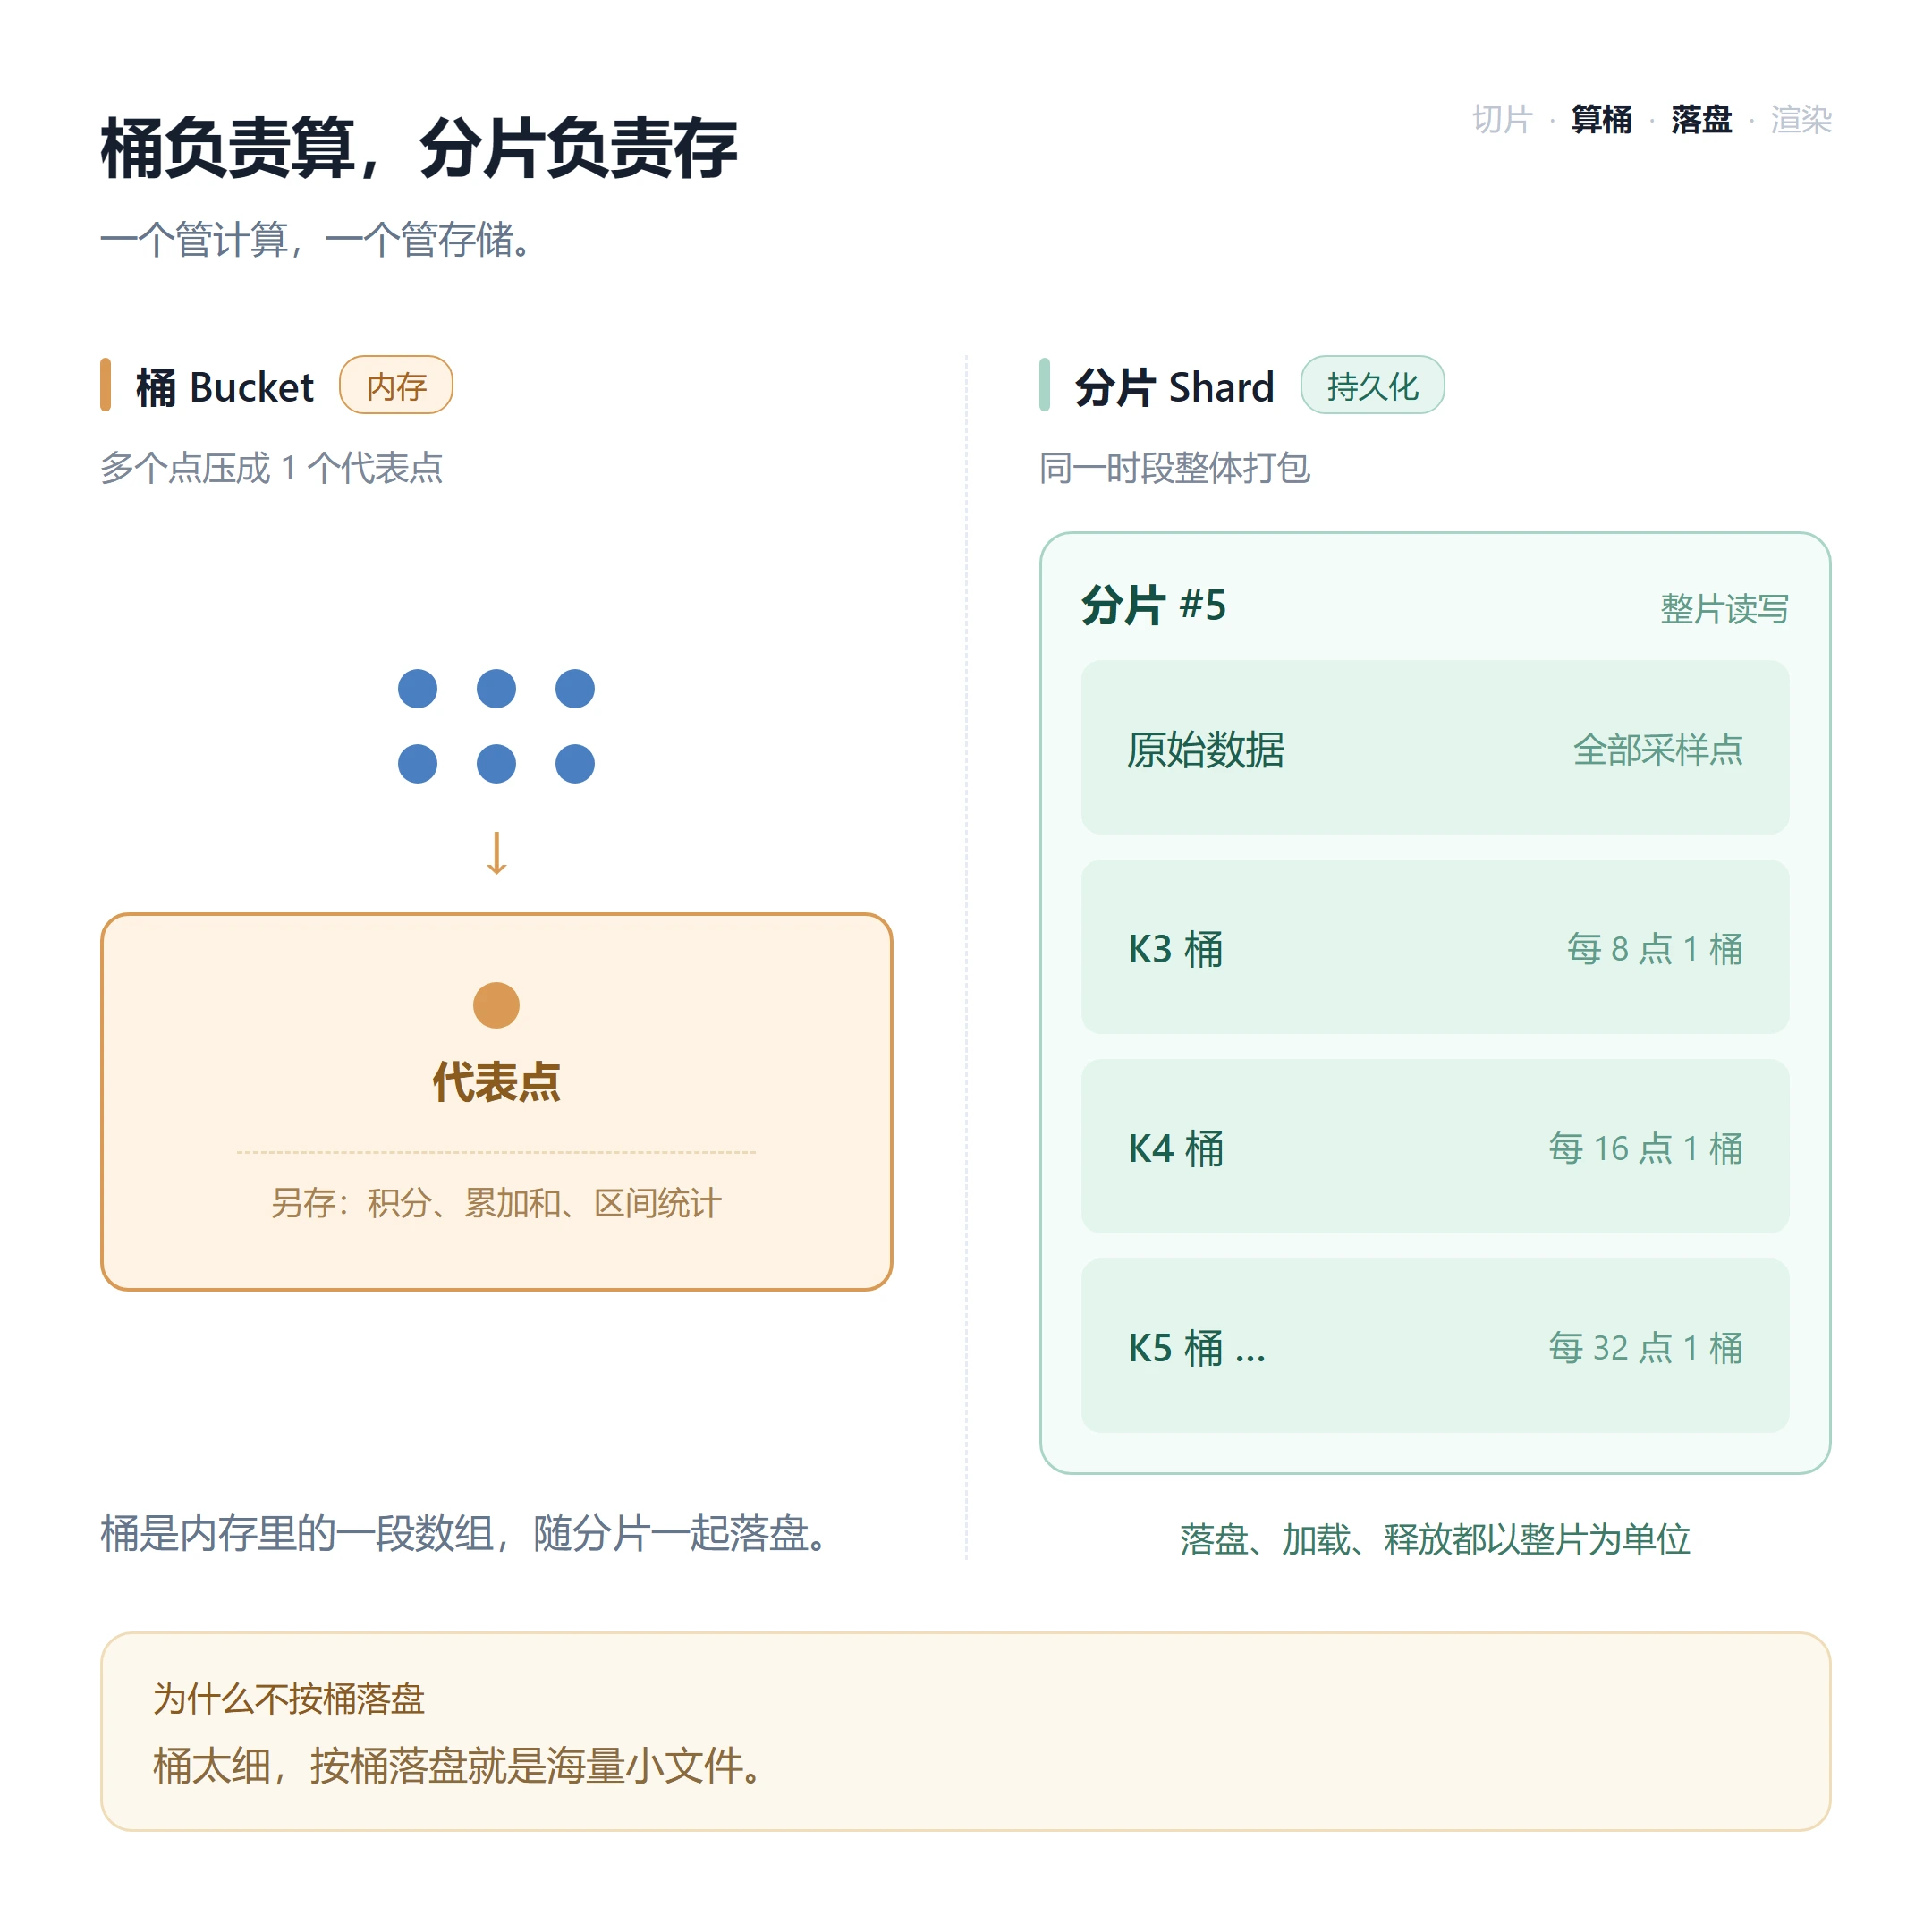
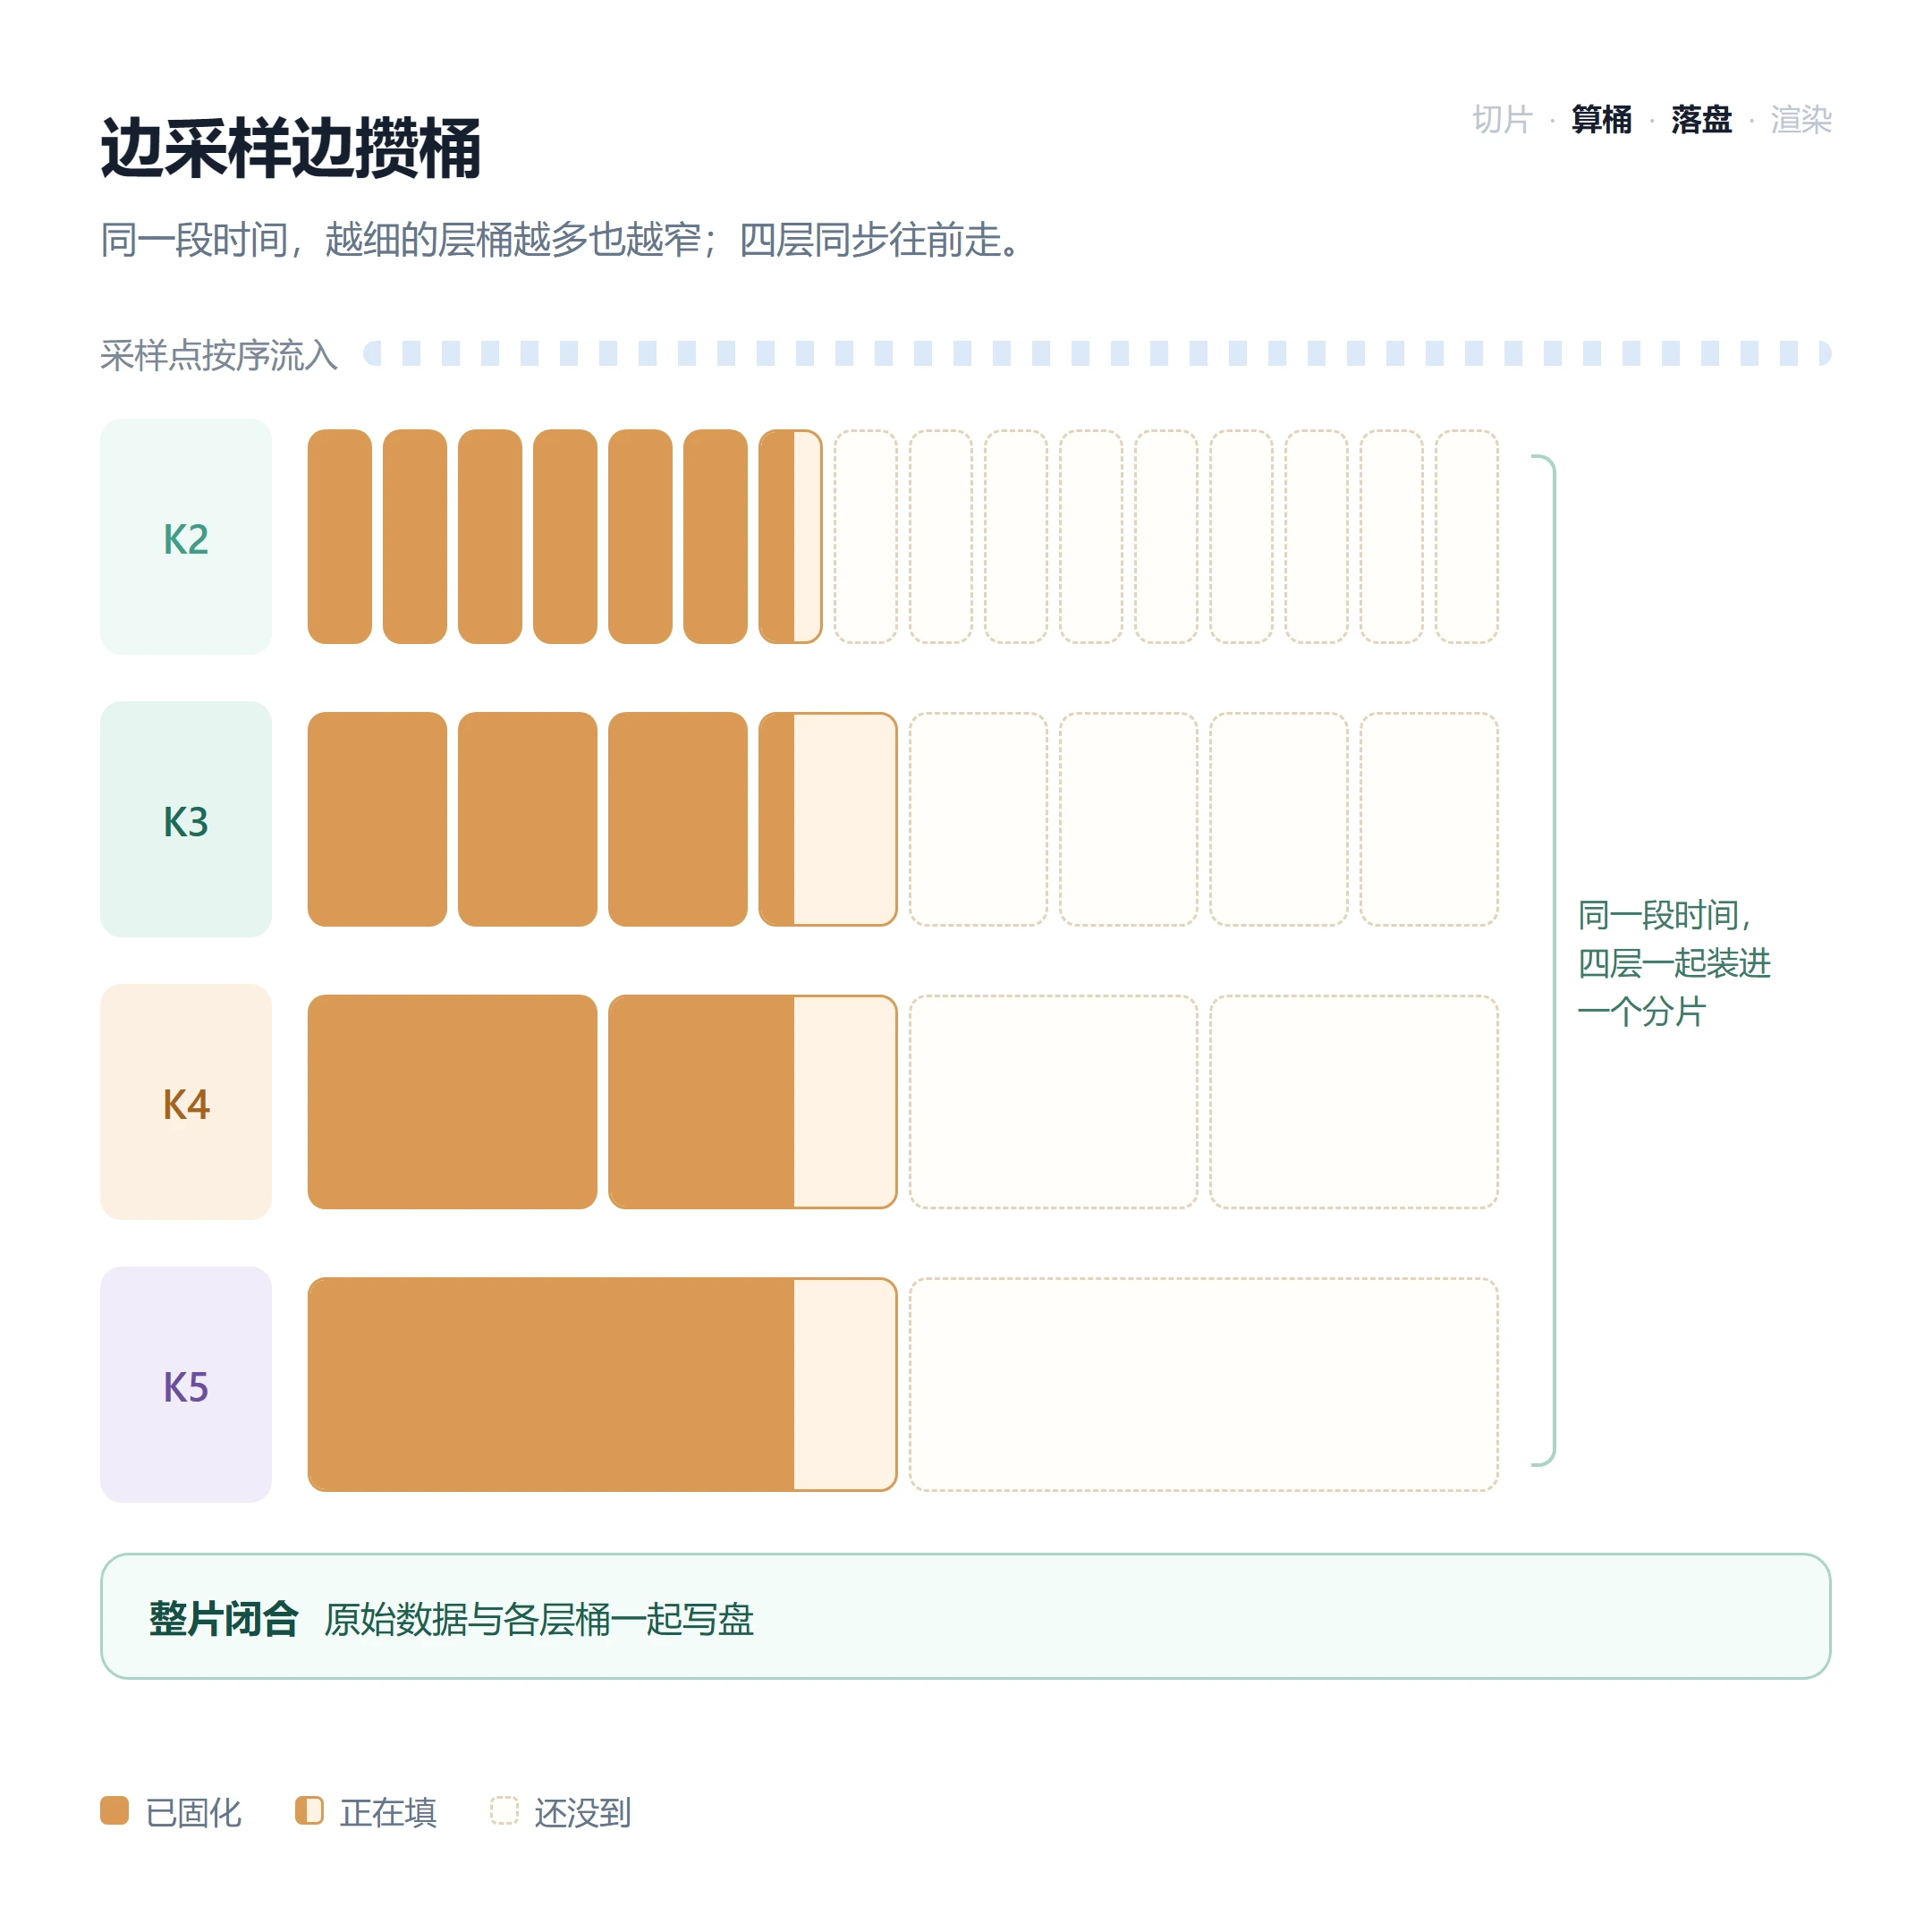
- 桶:降采样聚合的最小计算单元。每个桶吸收固定数量的连续原始采样点,输出一组聚合结果,包括波形代表点,也可包含积分、累加和等派生统计量;桶以数组元素形式存在于内存,不单独落盘。
- 分片:数据存储与加载的最小管理单元。按固定时长切分数据块,将该时段内所有层级的全部桶打包为一个整体,统一执行落盘、加载、释放操作。
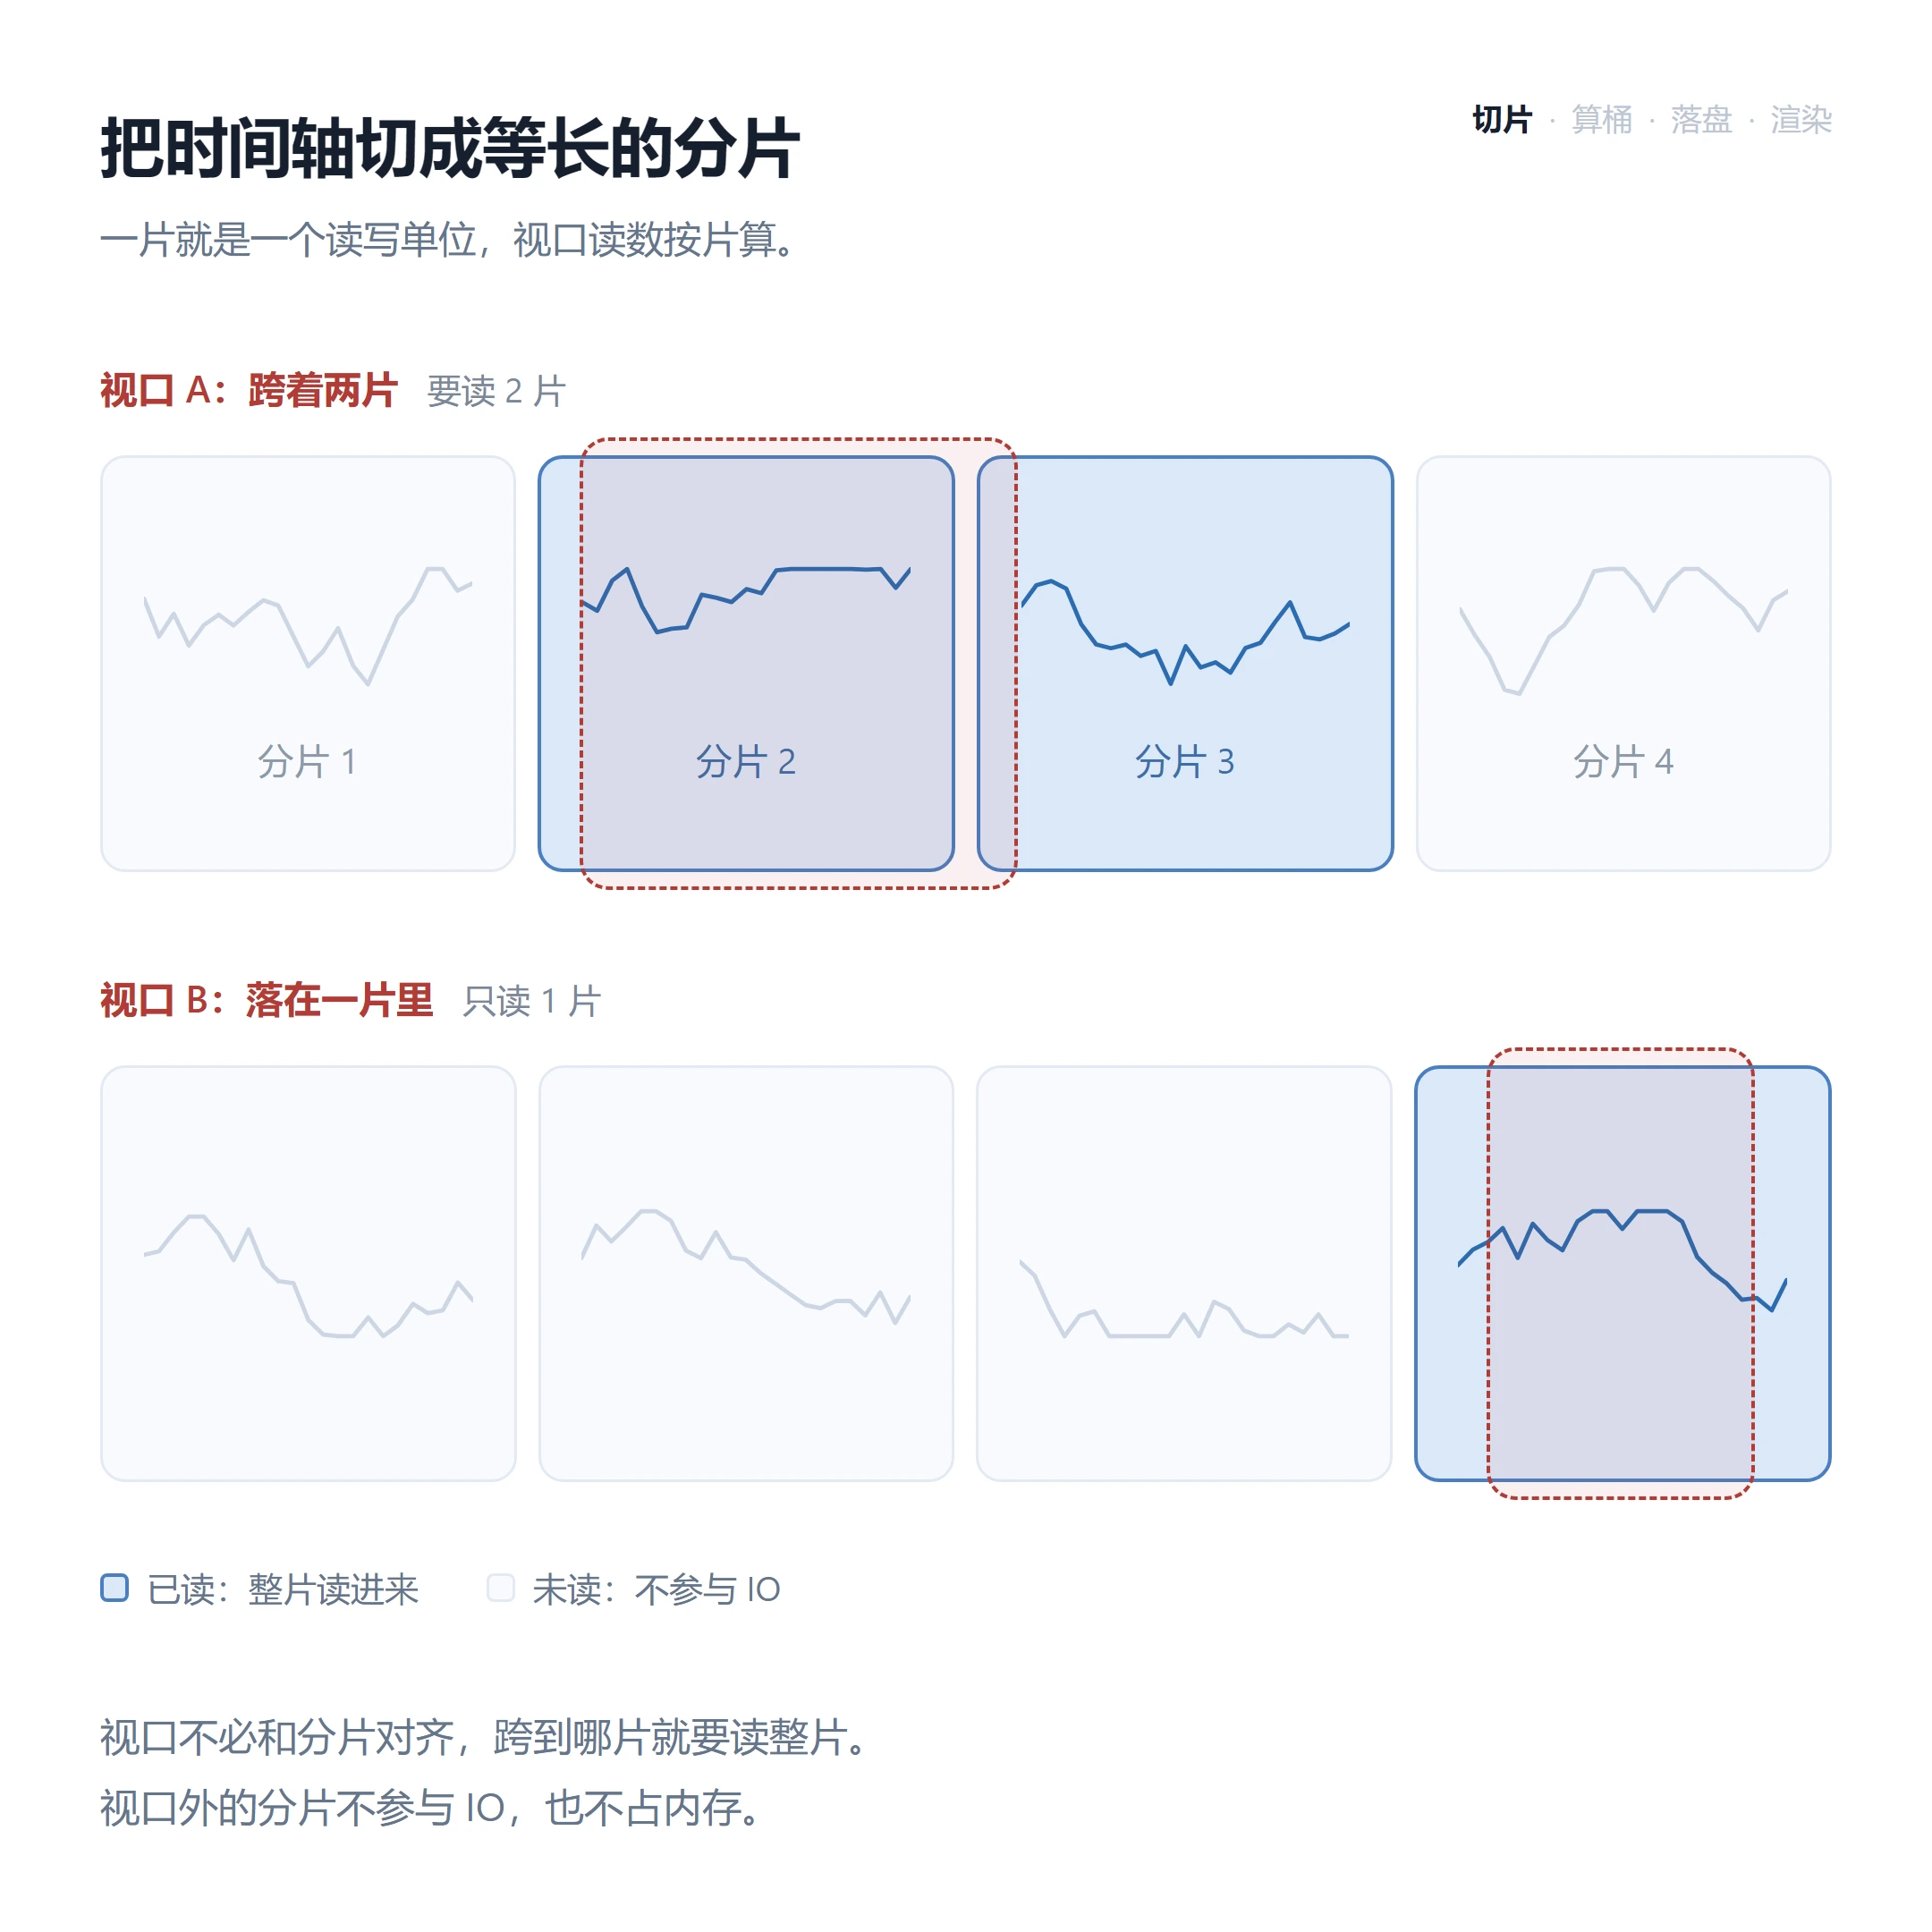
波形场景不适合像地图那样让瓦片同时承担计算与存储职责:波形聚合粒度很细,若以单个桶为单位落盘会产生海量小文件,管理与IO开销极高,因此必须将聚合计算与存储加载职责分离。
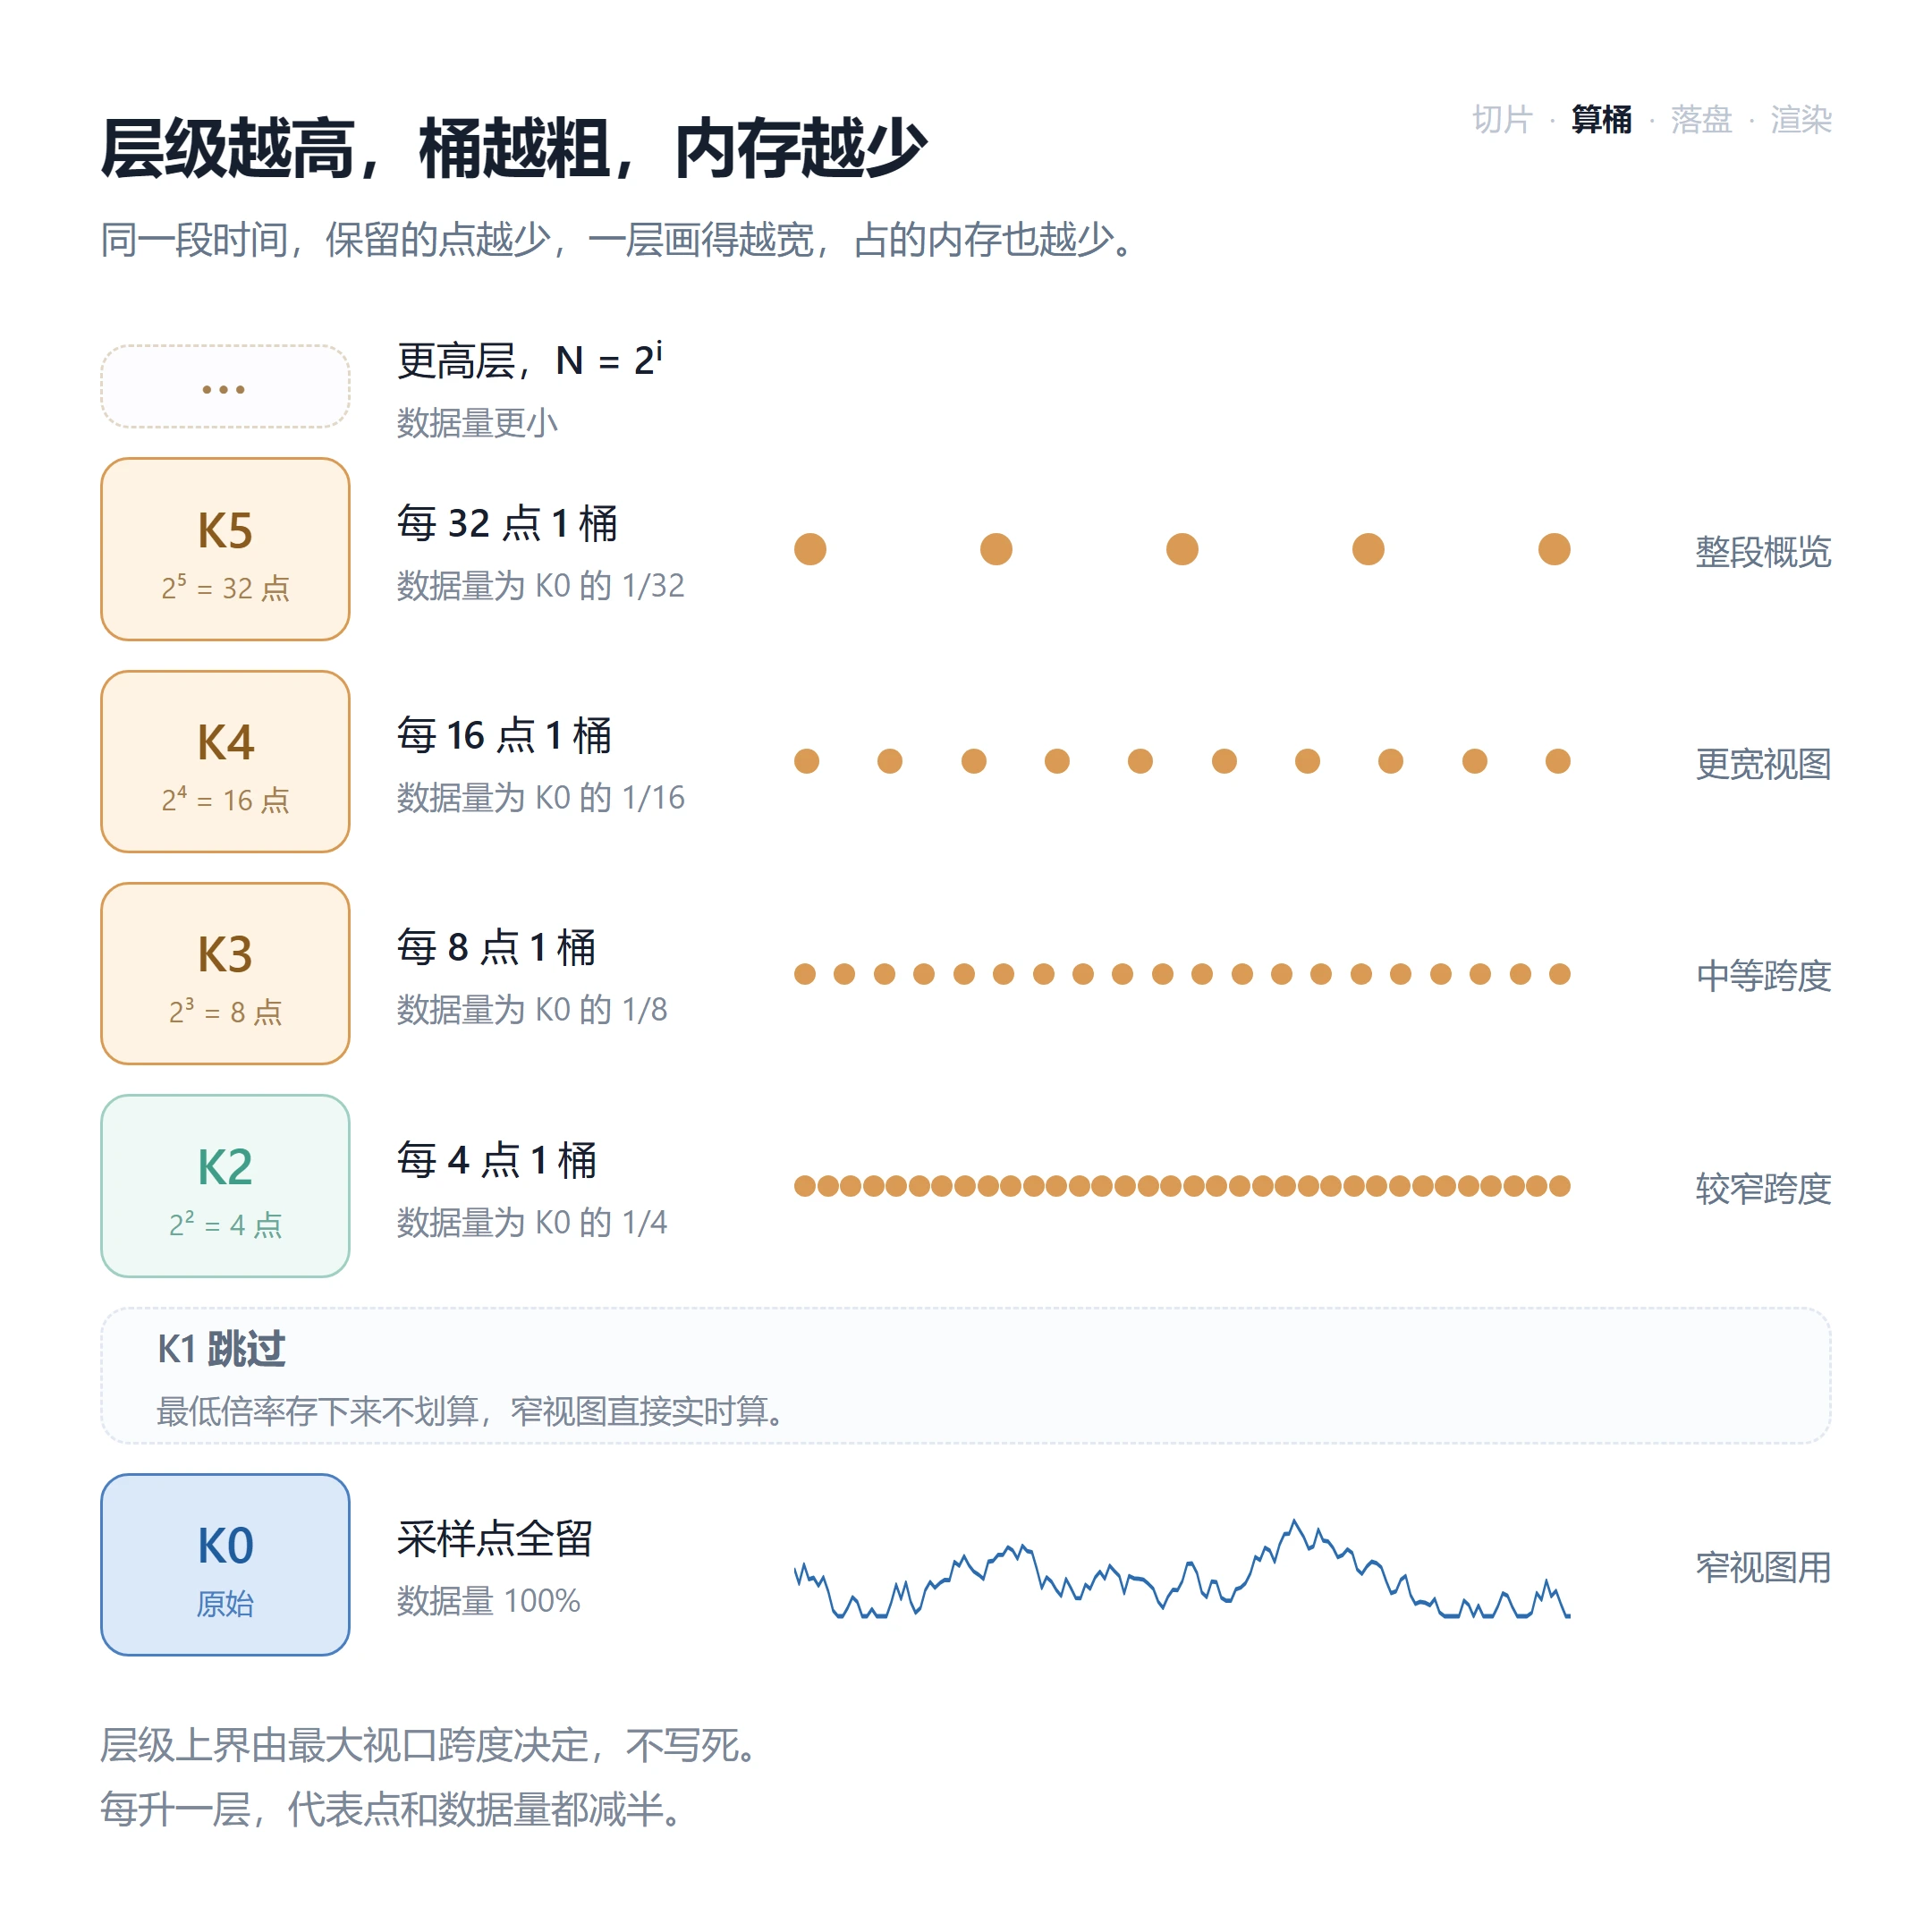
分层规则:预烘焙降采样层级从 起步,原始数据(k=0)仅作为底层数据源,不纳入预烘焙体系,同时跳过 k=1 这个最低倍率层级。低倍率层级数据占比高,但对应窄视图场景下实时聚合的计算成本极低,持久化存储的收益代价比不足,因此直接省略。层级上界由最大可视跨度动态决定,不硬编码固定值。
流式降采样构建逻辑
采样数据持续流入时,同步对所有预烘焙层级执行流式聚合;单个桶填满后立即固化,待整个分片闭合后,该分片全部层级的桶数据统一落盘持久化。 桶内聚合策略可按需选型,常见为极值法、平均值法等;积分、区间统计量等派生指标可同步计算并随桶存储,供后续查询直接复用。
渲染与查询路由
定义视口倍率 = 可视范围内总采样点数 / 屏幕像素数,按R分两条渲染路径:
- 窄视图(R低于阈值):直接读取原始数据,按像素实时动态聚合渲染,天然支持无级缩放与局部框选;
- 宽视图(R高于阈值):加载对应层级的预烘焙桶数据渲染,规避海量原始点的实时计算开销。
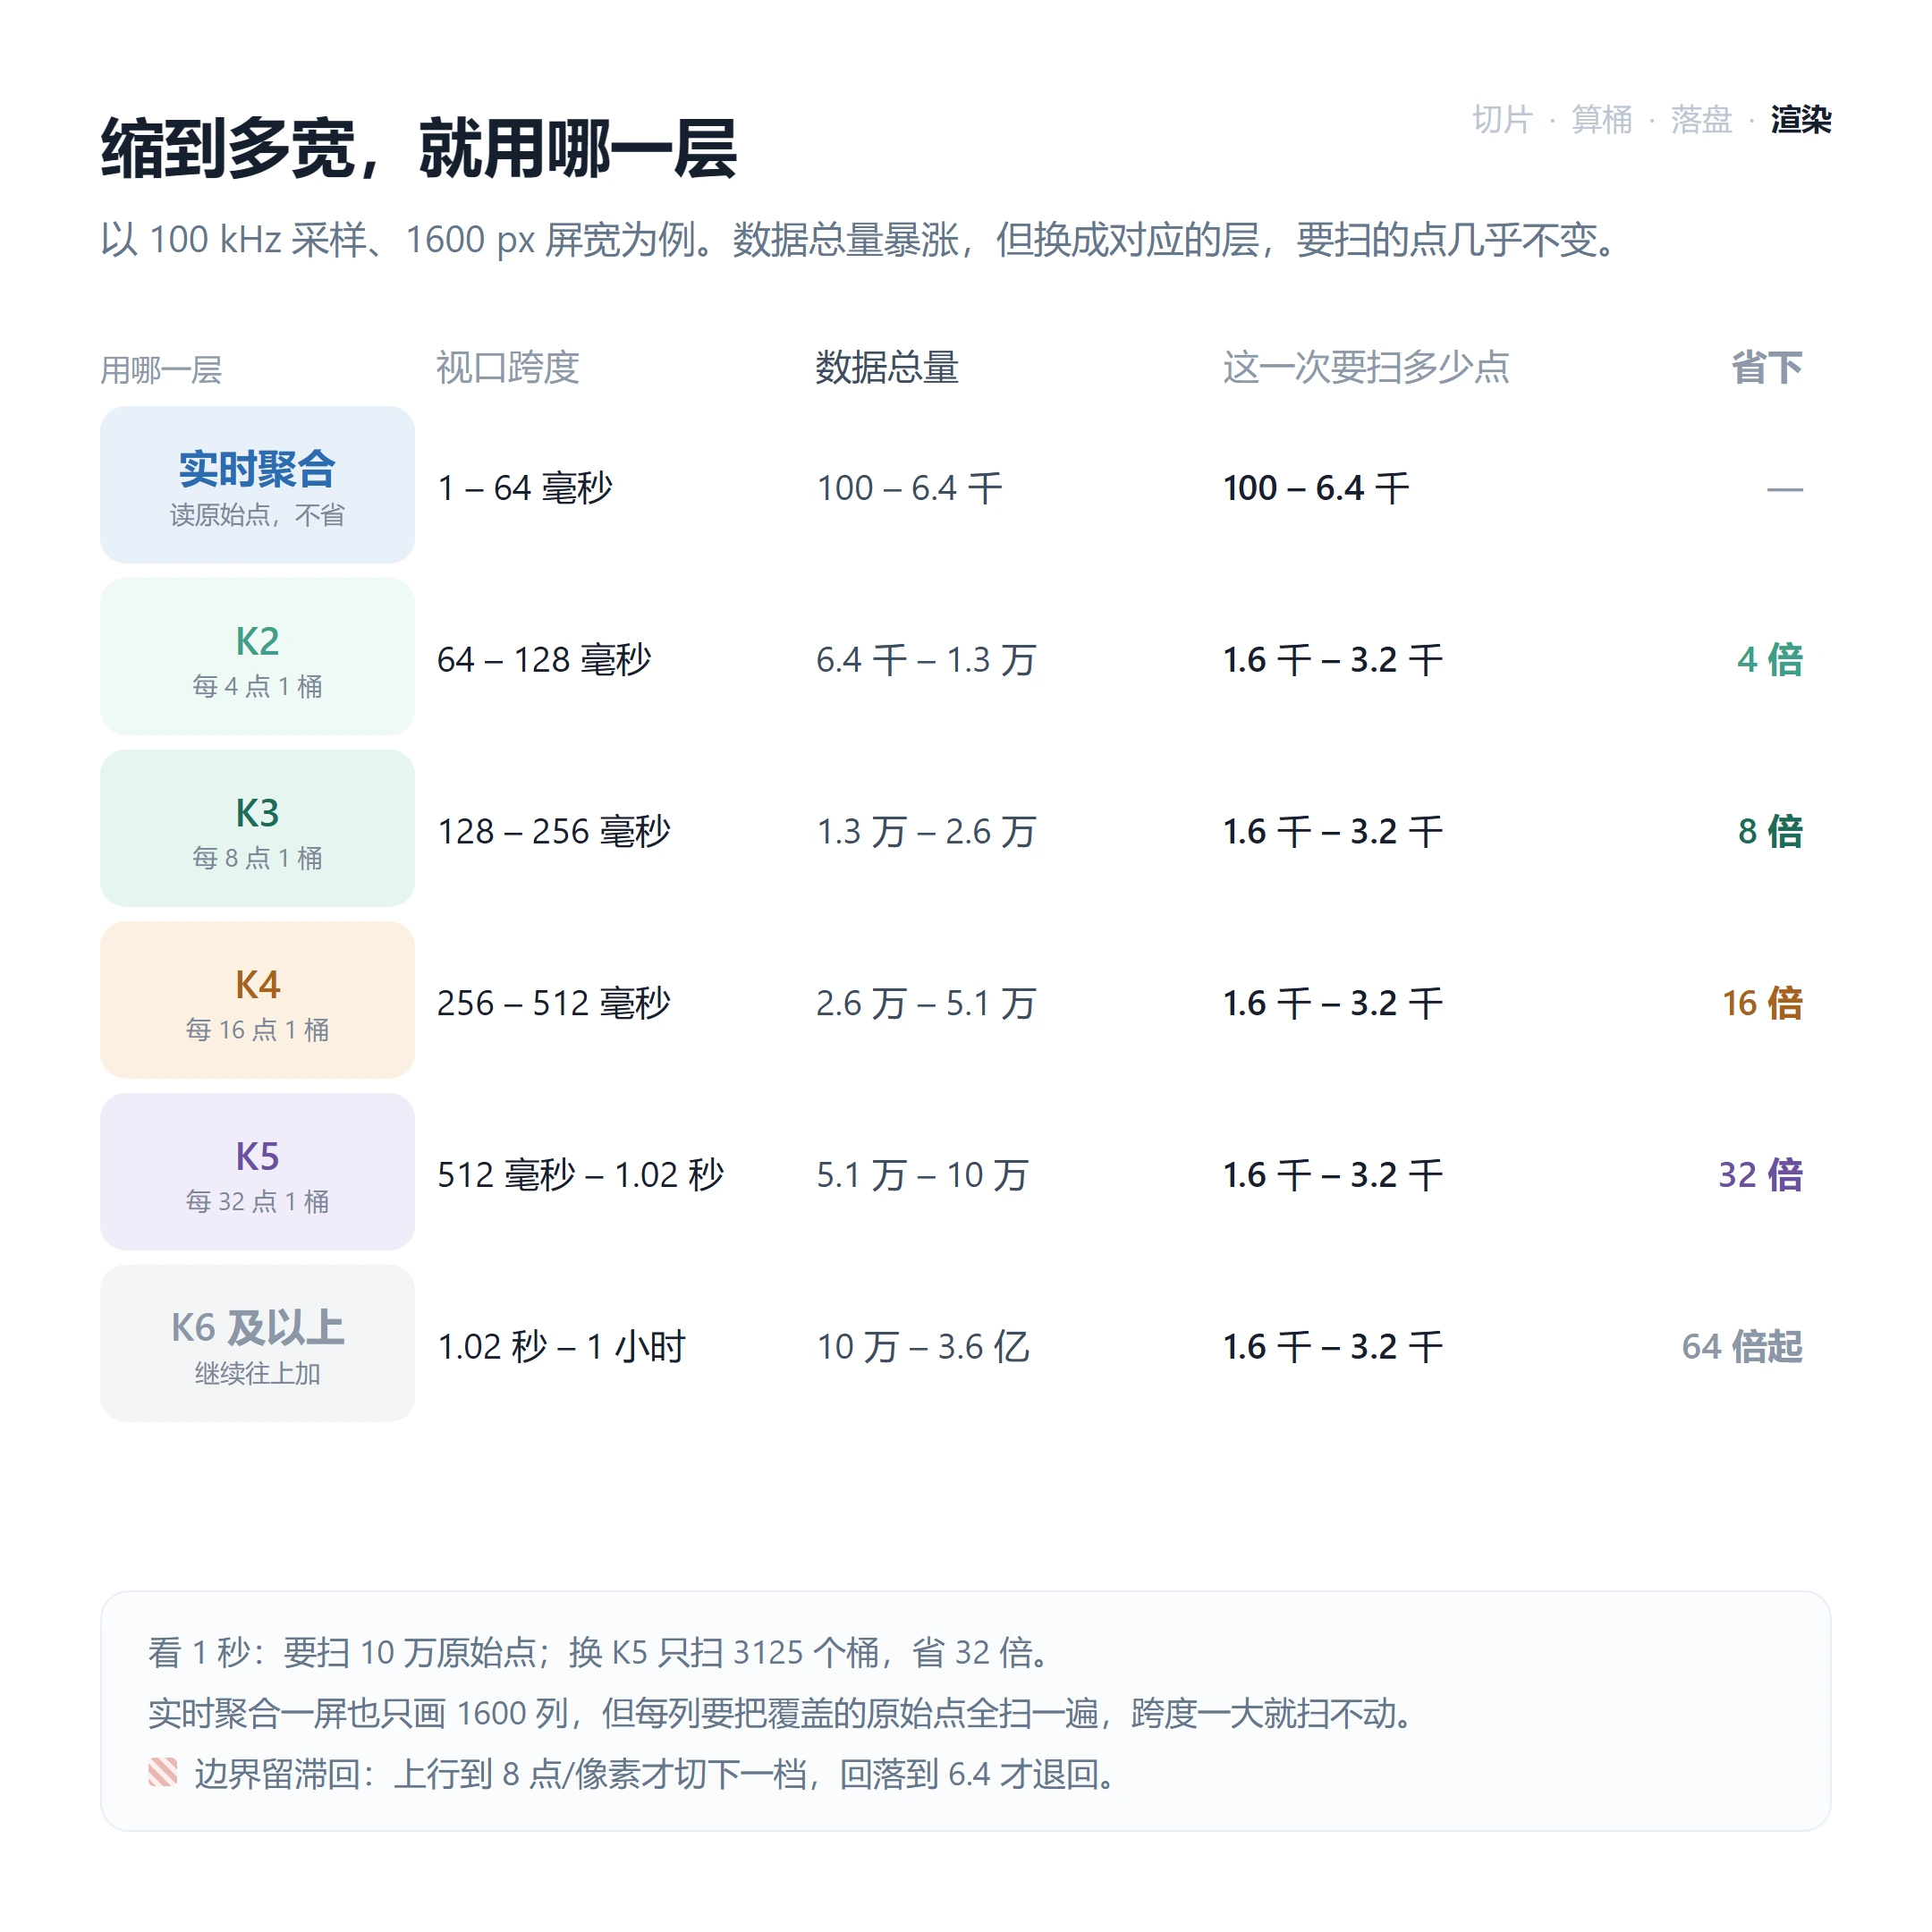
大范围统计查询(如区间积分、总量计算)可直接聚合对应区间的桶级预计算结果,无需逐点遍历原始数据。
切换设计:
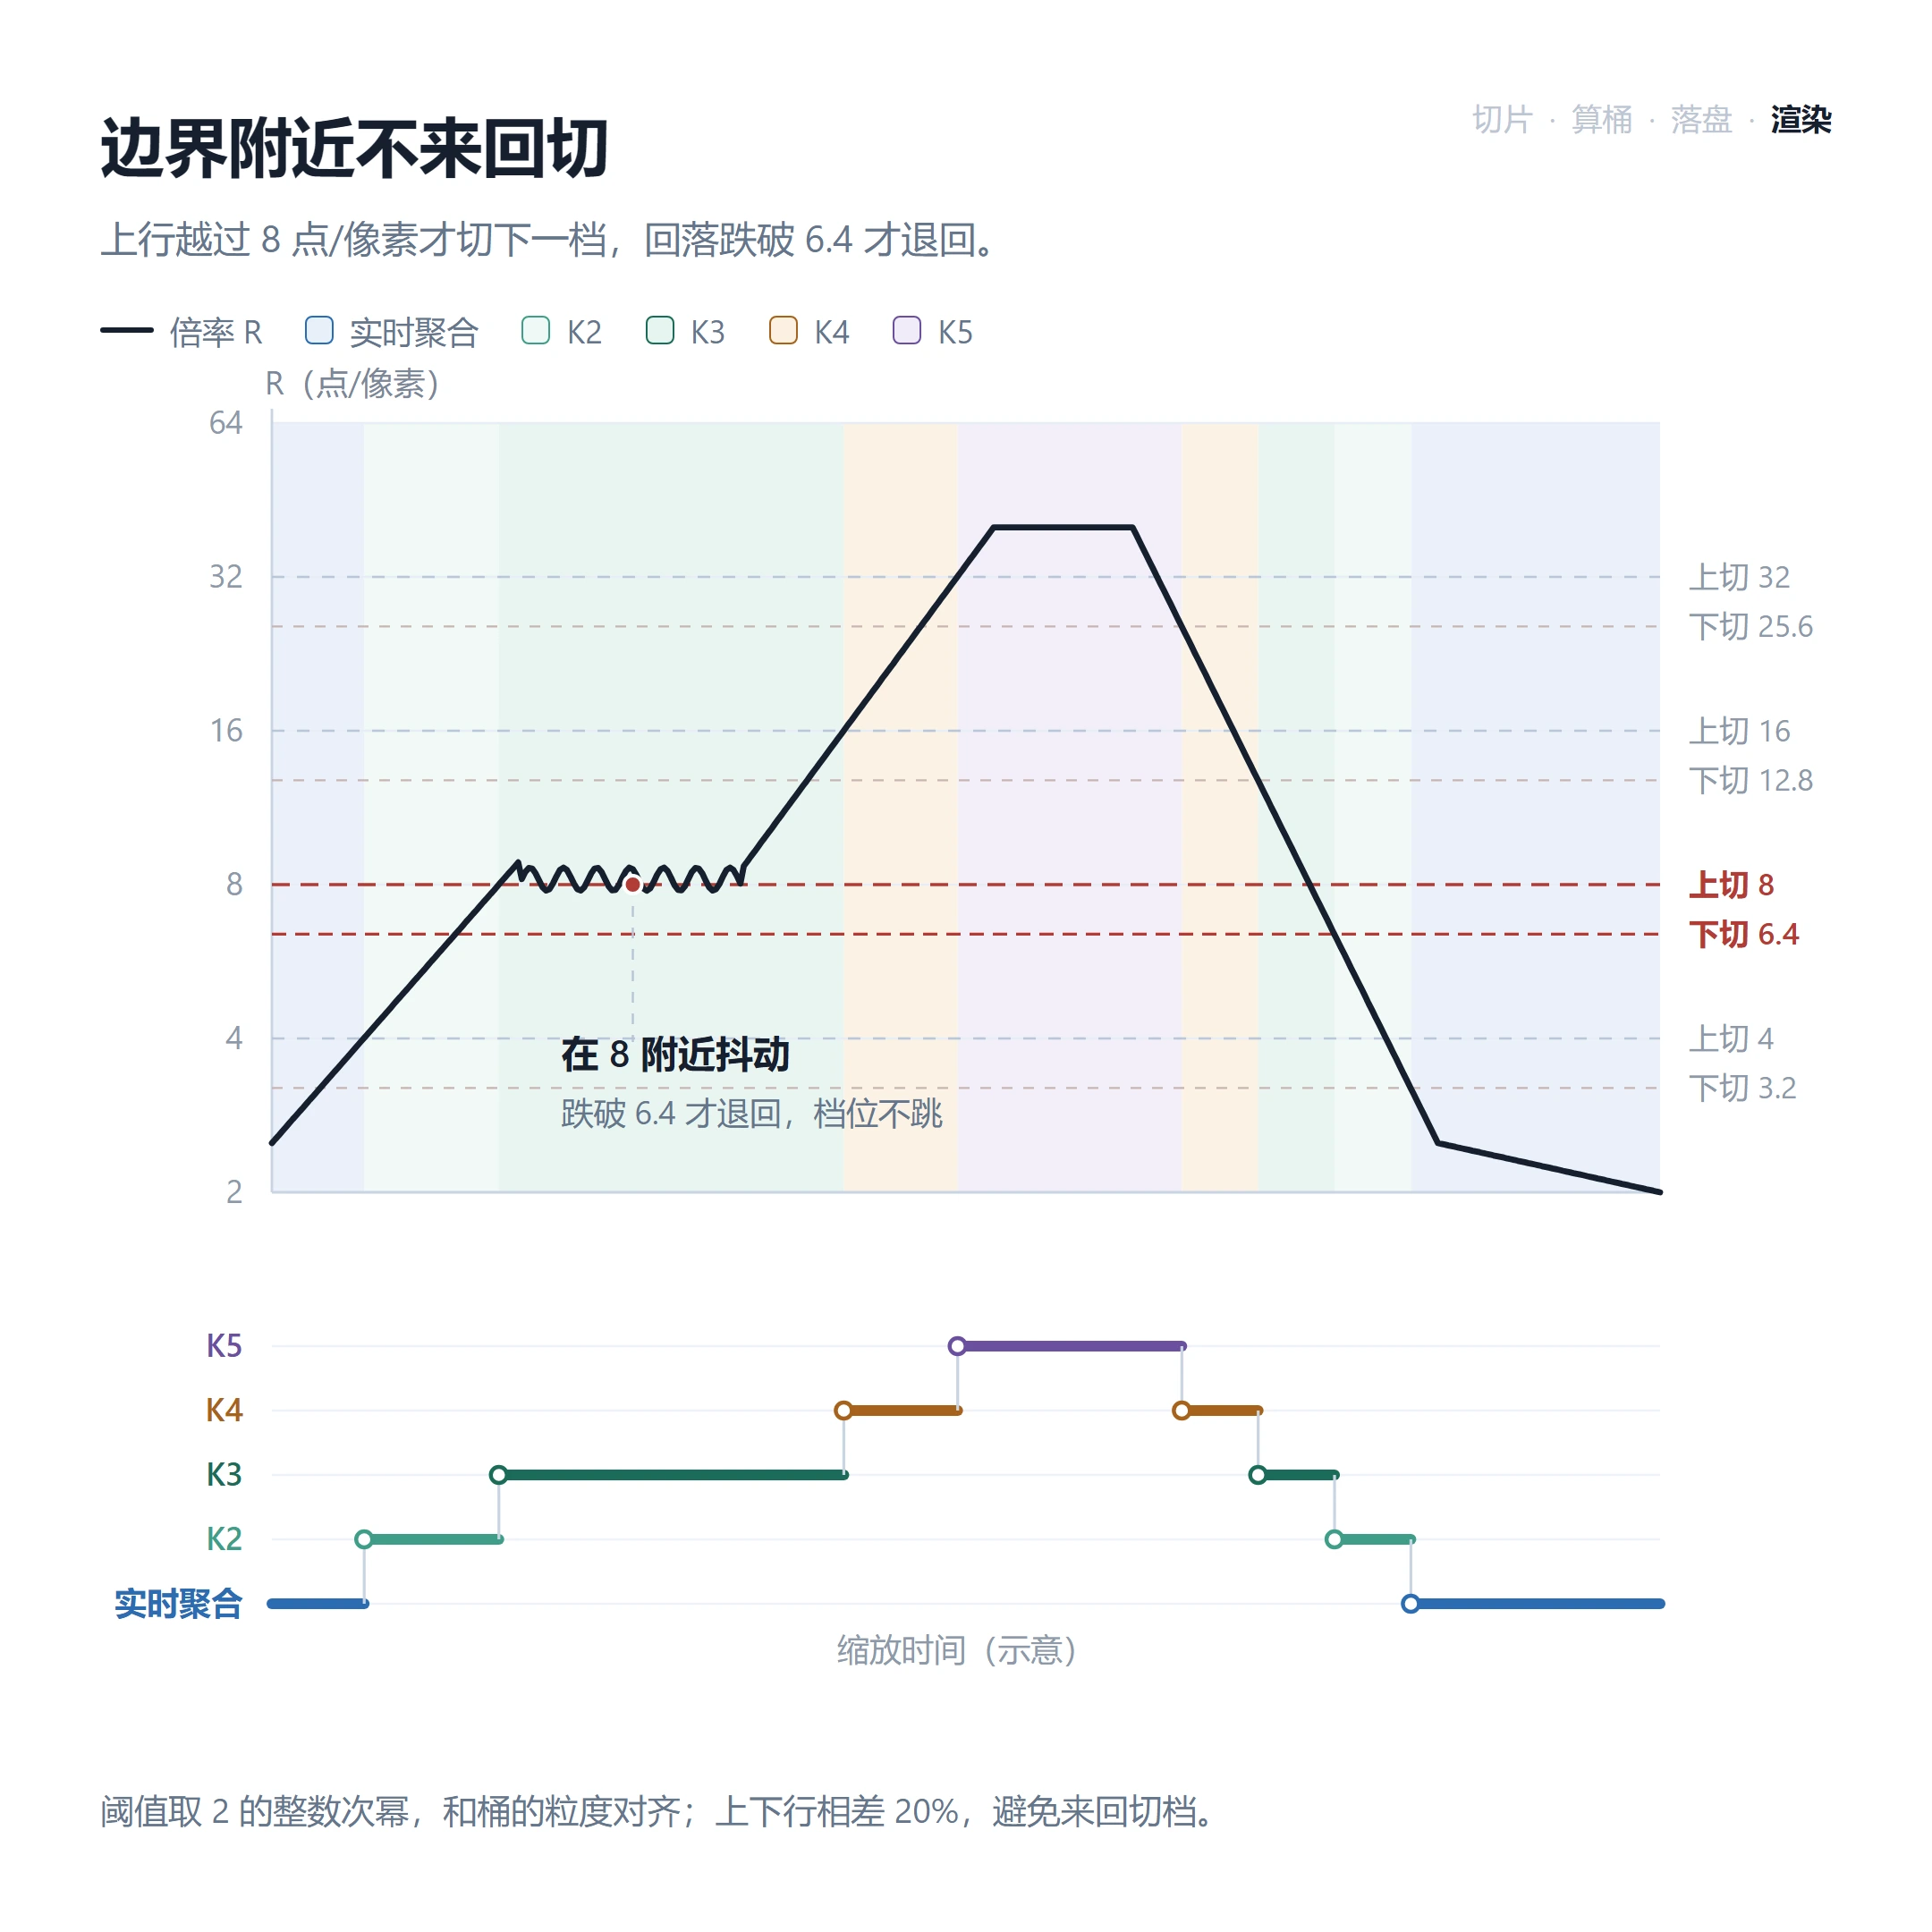
- 分界处设置滞回缓冲区间,避免轻微缩放触发层级反复切换;
- 手感差异:窄视图为无级连续缩放,波形平滑变化;宽视图为离散档位切换,层级跳转时波形细节存在跳变。
数据调度策略
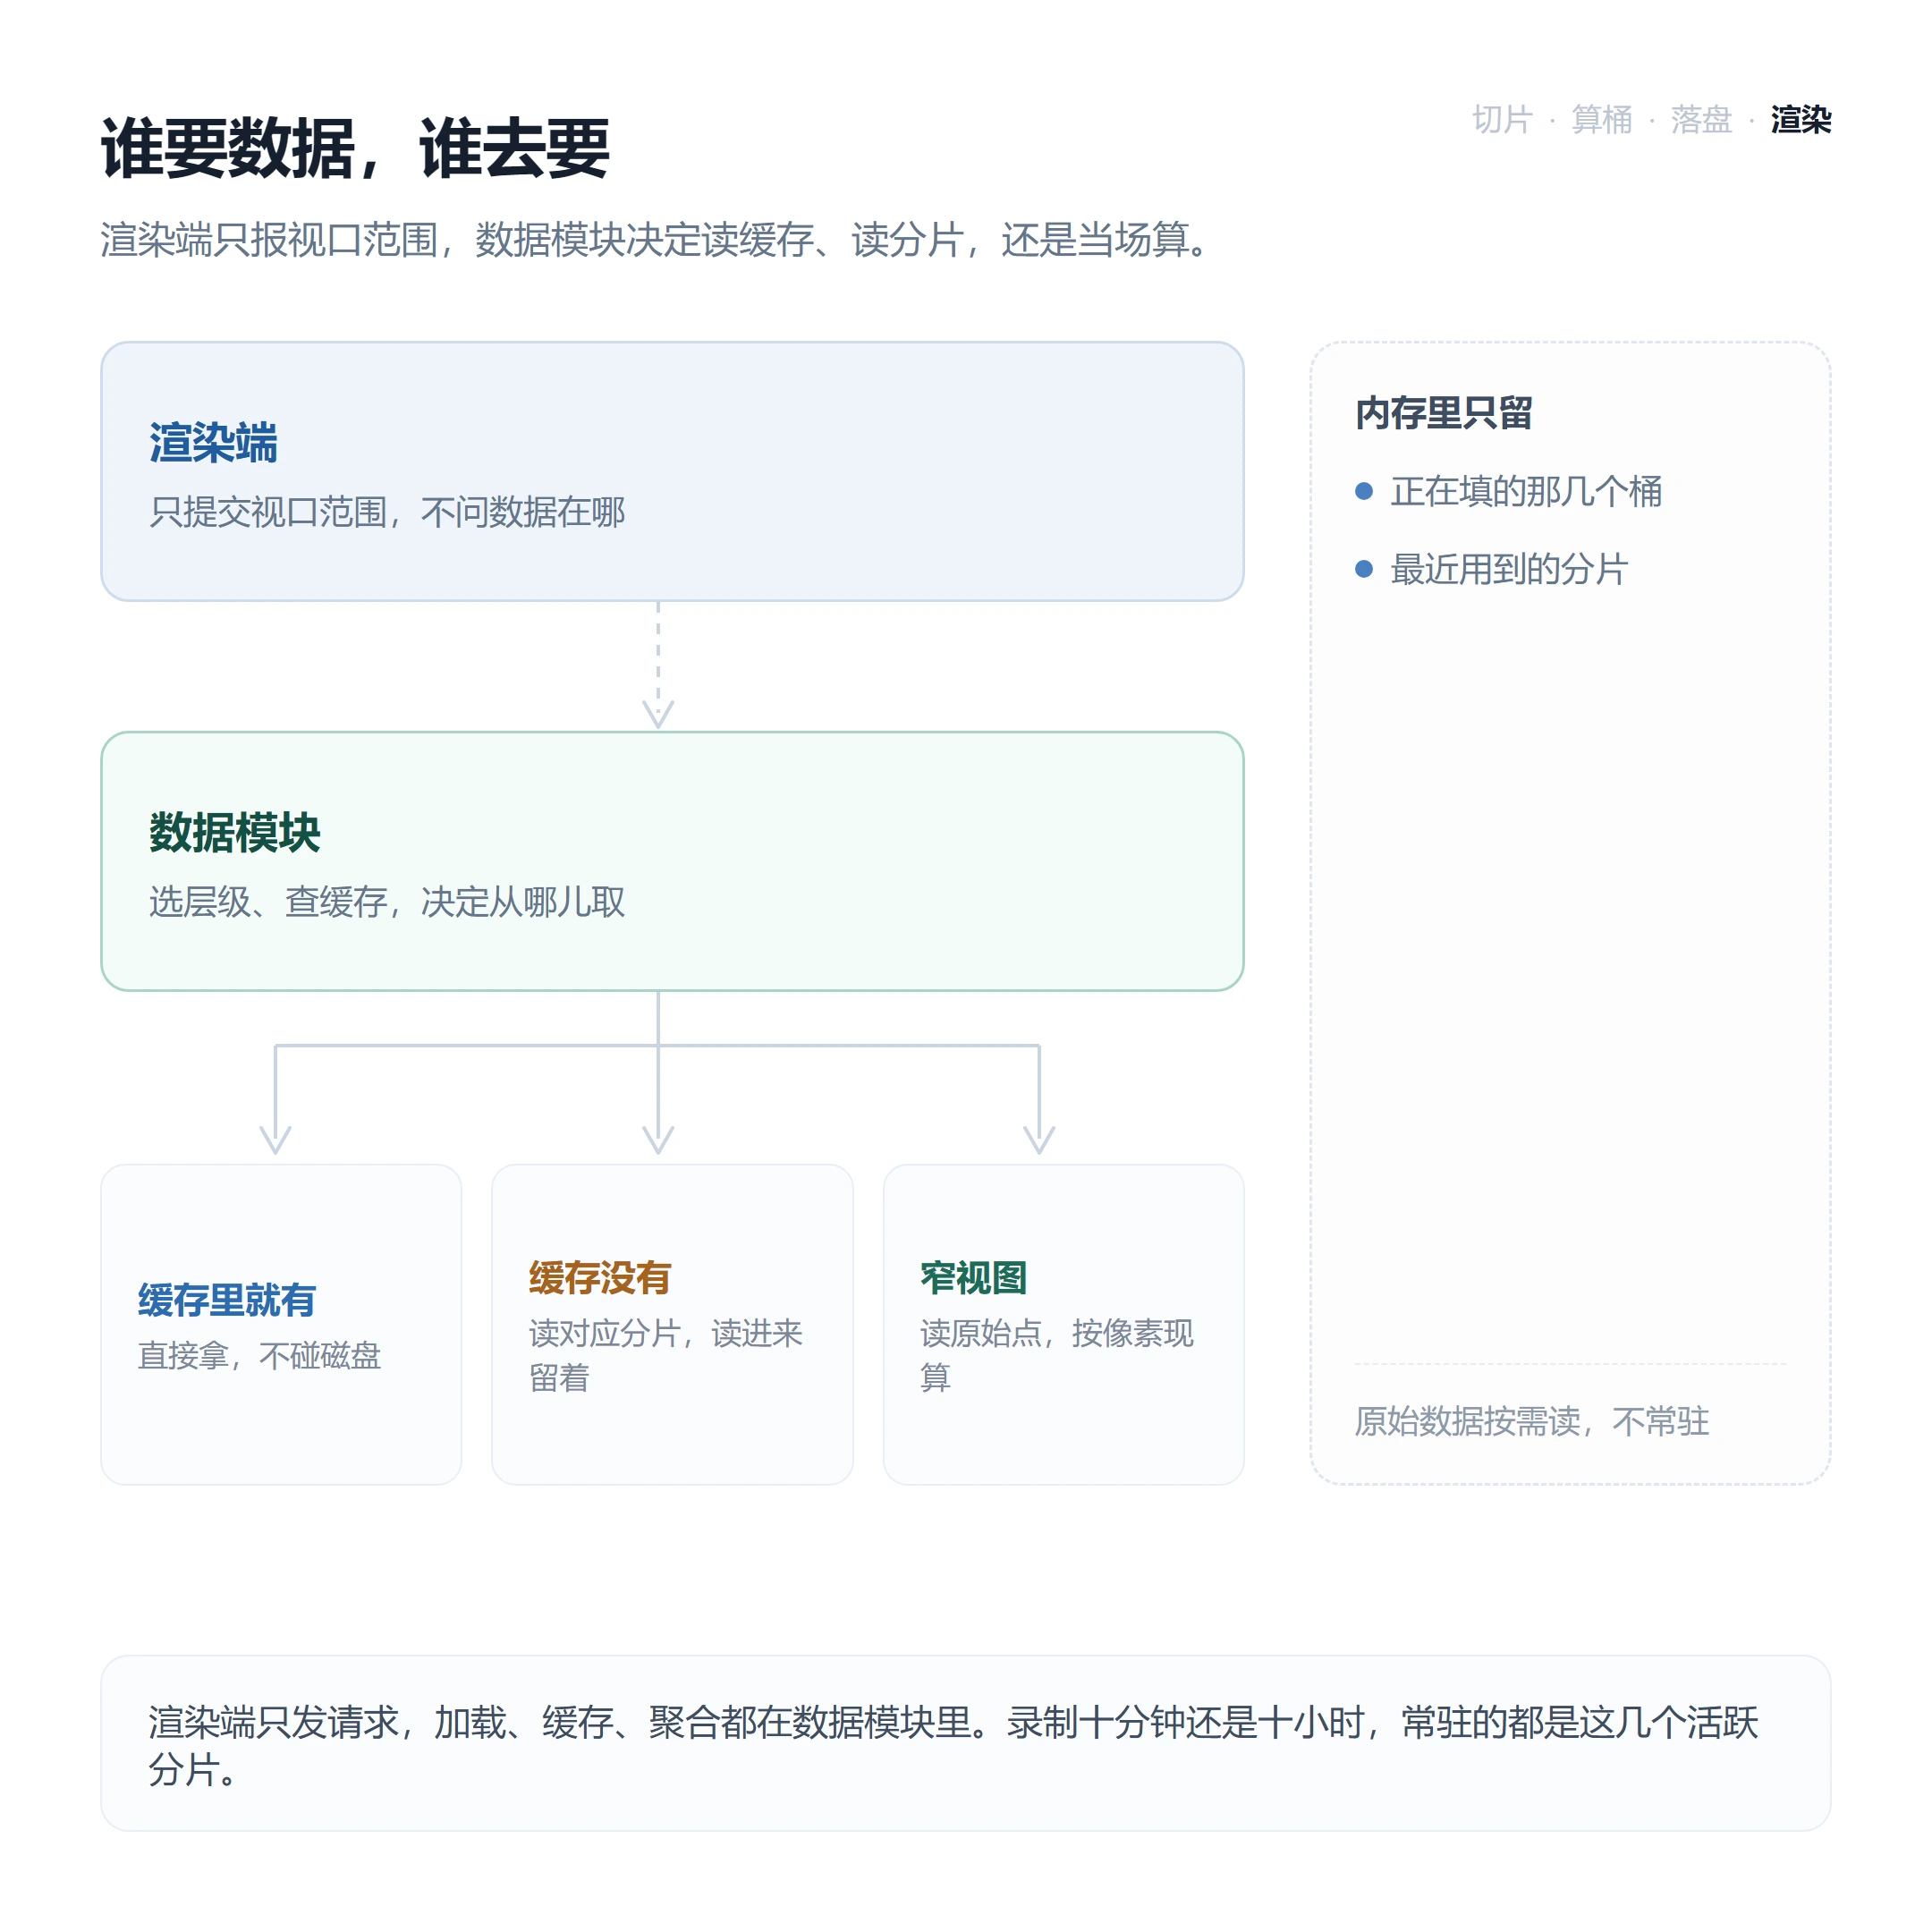
查询与计算解耦,渲染端仅提交视口范围请求,由数据模块负责加载缓存或执行实时聚合。 内存仅保留当前正在填充的未完成桶、近期访问分片的桶数据;原始数据按需读取,不常驻内存,内存占用与总录制时长解耦。
核心要点
- 预烘焙跳过低倍率层级,仅保留高倍率聚合层;原始数据仅作数据源,平衡存储开销与渲染性能;
- 桶为最小计算单元,分片为最小存储加载单元,二者职责分离,避免海量小文件带来的管理与IO开销;
- 流式构建多分辨率层级,桶内可预存波形代表点与派生统计量,分片闭合后批量落盘复用;
- 按视口倍率分级渲染:窄视图实时聚合保证无级交互,宽视图复用预烘焙数据保证流畅度;
- 大范围统计查询可直接复用桶内预计算结果,避免逐点遍历原始数据;
- 查询与计算解耦,内存仅保留活跃分片数据,常驻内存规模与录制总时长无关;
- 层级上界、切换阈值、分片粒度、聚合算法均为调优项,由开发者结合场景实测确定。